Spis treści
- Najważniejsze informacje o llms.txt
- Czym jest plik llms.txt i skąd wziął się nowy standard w sieci?
- Format Markdown a specyfika przetwarzania danych przez duże modele językowe
- Plik llms.txt a robots.txt i sitemap.xml – najważniejsze różnice
- Sterowanie dostępem botów a przekazywanie kontekstu merytorycznego
- Co rzeczywiście daje wdrożenie pliku llms.txt na stronie internetowej?
- Lepsza widoczność w wyszukiwarkach generatywnych i redukcja halucynacji AI
- Efektywniejsze przetwarzanie danych serwisu przez systemy Retrieval-Augmented Generation
- Czego plik llms.txt NIE ROBI? Rozprawiamy się z mitami
- Samo dodanie pliku nie zastąpi silnego SEO, autorytetu i danych strukturalnych
- Kiedy wdrożenie llms.txt ma głęboki sens biznesowy?
- Rozbudowane serwisy B2B, platformy e-commerce i witryny z gąszczem dokumentacji
- Jak prawidłowo stworzyć i wdrożyć plik llms.txt?
- FAQ – najważniejsze informacje o llms.txt
- Czym różni się llms.txt od robots.txt i ai.txt?
- Jak sprawdzić poprawność pliku llms.txt?
- Czy plik llms.txt jest przydatny i warto go wdrożyć?
- Jak często aktualizować plik llms.txt?
Najważniejsze informacje o llms.txt
Plik llms.txt stanowi uporządkowany zestaw informacji w formacie Markdown, przygotowany z myślą o programach przetwarzających tekst bez zbędnego kodu wizualnego. Rozwiązanie to pozwala zaoszczędzić limity tokenów w oknie kontekstowym, ponieważ omija skrypty, reklamy i skomplikowaną strukturę HTML. Narzędzie nie wymusza indeksowania na robotach wyszukiwarek, nie zastępuje tradycyjnych map witryny ani nie blokuje dostępu do wrażliwych danych. Z wdrożenia najbardziej skorzystają właściciele sklepów internetowych, autorzy dokumentacji technicznej oraz rozbudowane portale dla biznesu. Weryfikacja działania pliku opiera się na prostym teście odpowiedzi serwera oraz analizie czytelności linków przez asystentów cyfrowych.
Czym jest plik llms.txt i skąd wziął się nowy standard w sieci?
Plik llms.txt to lekki plik tekstowy w katalogu głównym domeny, który przedstawia strukturę serwisu i streszczenia podstron w formie zrozumiałej dla sztucznej inteligencji. Jeśli zastanawiasz się, czym jest plik llms.txt i co to oznacza w codziennej praktyce, pomyśl o nim jak o spisie treści przygotowanym specjalnie dla algorytmów czytających sieć. Standard powstał z inicjatywy społeczności skupionej wokół projektu Answer.ai pod przewodnictwem Jeremy’ego Howarda. Twórcy zauważyli, że tradycyjne strony internetowe zawierają zbyt wiele elementów graficznych i programistycznych, które utrudniają maszynom szybkie dotarcie do sedna wiedzy. Udostępniając ten plik, dajesz botom skróconą wersję portalu i ułatwiasz im zrozumienie tematyki Twoich publikacji.
Format Markdown a specyfika przetwarzania danych przez duże modele językowe
Aby zrozumieć, jak w praktyce działa plik llms.txt, musisz przyjrzeć się temu, jak systemy językowe przetwarzają surowy kod stron internetowych. Gdy algorytm pobiera zwykłą podstronę, musi najpierw usunąć znaczniki sekcji, style wyglądu oraz skrypty analityczne, co pochłania sporą część dostępnej pamięci operacyjnej. Markdown eliminuje ten narzut, oferując przejrzystą hierarchię nagłówków, akapitów i odnośników bez żadnych dekoratorów wizualnych. Dzięki temu modele AI mogą natychmiast przejść do analizy logicznej zdań i wyciągania definicji. Właśnie dlatego LLM-y w content marketingu stają się tak powszechne, zmuszając twórców do upraszczania formatów przekazywania wiedzy.
Plik llms.txt a robots.txt i sitemap.xml – najważniejsze różnice
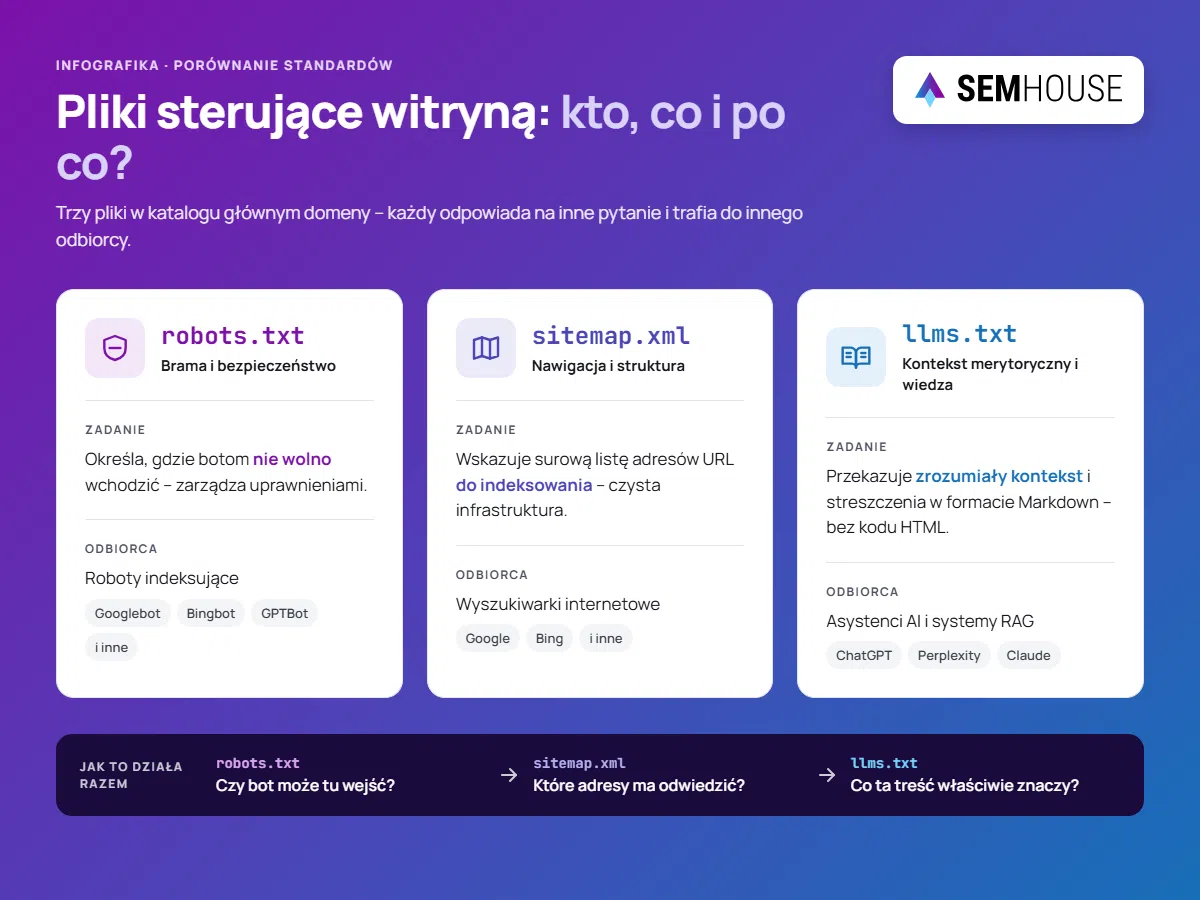
Podstawowa różnica między llms.txt a starszymi standardami polega na tym, że nowy format przekazuje znaczenie treści, podczas gdy robots.txt zarządza uprawnieniami, a sitemap.xml wskazuje wyłącznie ścieżki indeksowania. Protokół wykluczania robotów mówi maszynom, do których katalogów nie wolno im wchodzić ze względów bezpieczeństwa. Z kolei mapa witryny w języku XML to sucha lista adresów, która nie informuje o powiązaniach pojęciowych między artykułami. Plik dla modeli językowych zawiera natomiast opisy poszczególnych działów i podsumowania oferty napisane prostym językiem. Każdy z tych trzech elementów realizuje zupełnie inne zadanie w architekturze Twojego serwisu.
Sterowanie dostępem botów a przekazywanie kontekstu merytorycznego
Wielu administratorów błędnie zakłada, że mapa w formacie XML wystarczy, by algorytmy zrozumiały profil ich działalności. Zwykły plik indeksujący nie wyjaśni maszynie, czym różni się Twój flagowy program od pobocznego artykułu poradnikowego. Kiedy bot pobiera llms.txt, czyta przygotowane przez Ciebie wprowadzenie merytoryczne i dowiaduje się, jakie zagadnienia rozwiązujesz. Dzięki temu systemy AI nie muszą zgadywać przeznaczenia poszczególnych podstron na podstawie wyrywkowych nagłówków. Otrzymujesz kontrolę nad narracją, którą algorytmy przyswajają podczas analizy Twojej domeny.
Co rzeczywiście daje wdrożenie pliku llms.txt na stronie internetowej?
Wdrożenie pliku llms.txt na stronie internetowej zapewnia asystentom sztucznej inteligencji bezpośredni dostęp do autoryzowanych informacji o Twojej ofercie bez zakłóceń wywoływanych przez kod HTML. Kiedy systemy zewnętrzne pobierają taki dokument, otrzymują gotowy zestaw faktów opracowany przez Ciebie, a nie przypadkowo zinterpretowane fragmenty szablonu graficznego. Poprawiasz w ten sposób szansę na to, że silnik odpowiadający na zapytania klientów zacytuje precyzyjną definicję Twoich usług. Taki zabieg wspiera szeroko rozumiane pozycjonowanie AI, które polega na budowaniu widoczności w silnikach generatywnych. Zyskujesz większą pewność, że programy nie pominą ważnych materiałów edukacyjnych podczas przeszukiwania sieci.
Lepsza widoczność w wyszukiwarkach generatywnych i redukcja halucynacji AI
Halucynacje pojawiają się wtedy, gdy algorytm nie dysponuje jednoznacznymi danymi źródłowymi i zaczyna tworzyć prawdopodobne, lecz zmyślone odpowiedzi. Udostępniając przejrzyste streszczenia w formacie Markdown, ograniczasz ryzyko, że asystent przypisze Twojej firmie nieistniejące funkcje. Modele AI chętniej opierają swoje twierdzenia na zwięzłych tekstach, które mogą łatwo zweryfikować w ułamku sekundy. Precyzyjne opisy linków ułatwiają robotom przypisanie właściwych adresów źródłowych do generowanych odpowiedzi. W efekcie Twoja strona częściej pojawia się jako źródło wiedzy w oknach dialogowych.
Efektywniejsze przetwarzanie danych serwisu przez systemy Retrieval-Augmented Generation
Mechanizm wspomagania generowania wiedzą zewnętrzną, czyli RAG, polega na wyszukiwaniu pasujących fragmentów informacji w zewnętrznych bazach w momencie zadawania pytania przez człowieka. Standardowy proces wymaga podzielenia tekstu strony na mniejsze kawałki, co przy chaotycznym kodzie witryny często prowadzi do błędów logicznych. Plik llms.txt podaje gotowe, spójne fragmenty tekstu bez potrzeby ich mozolnego oczyszczania ze skryptów. Taka struktura pozwala silnikowi semantycznemu błyskawicznie odnaleźć właściwy akapit i przygotować odpowiedź dla użytkownika. Aby wiedzieć, jak takie wdrożenia przekładają się na obecność w odpowiedziach asystentów, sprawdzaj regularnie widoczność w LLM-ach za pomocą dostępnych wskaźników analitycznych.
Czego plik llms.txt NIE ROBI? Rozprawiamy się z mitami
Plik llms.txt nie gwarantuje bezpośredniego wzrostu pozycji w tradycyjnych wynikach wyszukiwania, nie zmusza algorytmów do cytowania Twojej domeny ani nie zastępuje sprawdzonych działań optymalizacyjnych. Wokół tego formatu narosło wiele przesadnych obietnic sugerujących, że samo umieszczenie pliku na serwerze podwoi ruch organiczny w kilka dni. Rzeczywistość techniczna pokazuje, że roboty traktują ten dokument jako ułatwienie, a nie nakaz prawny czy algorytmiczny. Jeśli witryna publikuje treści niskiej próby, obecność pliku tekstowego w żaden sposób tego nie zamaskuje. Traktuj ten format jako kanał dystrybucji wiedzy, a nie drogę na skróty.
Samo dodanie pliku nie zastąpi silnego SEO, autorytetu i danych strukturalnych
Zaufanie wyszukiwarek i asystentów buduje się przez lata na bazie wartościowych publikacji oraz odnośników z innych poważnych serwisów. Żaden algorytm nie uzna anonimowej strony za rzetelne źródło wyłącznie dlatego, że jej właściciel przygotował perfekcyjny plik Markdown. Równie istotne pozostają mikrodane Schema, które tłumaczą robotom cenniki, daty wydarzeń oraz autorstwo artykułów w ustandaryzowany sposób. Rozbieżności między treścią pliku tekstowego a faktyczną zawartością podstron skończą się zignorowaniem Twoich deklaracji. Zanim zaczniesz wdrażać nowinki techniczne, zamów rzetelny audyt widoczności w AI, który wskaże ewentualne luki informacyjne w Twoim serwisie.
Kiedy wdrożenie llms.txt ma głęboki sens biznesowy?
Wdrożenie llms.txt ma głęboki sens biznesowy wtedy, gdy Twoja witryna zawiera rozbudowaną wiedzę techniczną, skomplikowaną ofertę usługową lub tysiące specyfikacji produktowych, które gubią się w strukturze standardowego szablonu HTML. Jeśli prowadzisz prostą wizytówkę jednoosobowej działalności z kilkoma zakładkami, asystenci poradzą sobie z odczytaniem Twoich danych bez specjalnego pliku pomocniczego. Sytuacja zmienia się diametralnie, gdy odbiorcy zadają narzędziom konwersacyjnym szczegółowe pytania o parametry oferowanych przez Ciebie urządzeń. Podanie tych danych w czytelnej strukturze bezpośrednio przekłada się na jakość odpowiedzi udzielanych potencjalnym klientom. Warto też obserwować, jak reklamy wchodzą do środowisk konwersacyjnych, zmieniając sposób docierania do odbiorców.
Rozbudowane serwisy B2B, platformy e-commerce i witryny z gąszczem dokumentacji
W branży oprogramowania oraz bibliotek programistycznych użytkownicy masowo pytają asystentów cyfrowych o gotowe fragmenty kodu i dokumentację funkcji. Udostępnienie pliku llms.txt pozwala takim narzędziom natychmiast odczytać prawidłową składnię bez błądzenia po dziesiątkach podstron pomocy. Z kolei w rozbudowanym sklepie internetowym plik może skierować bota bezpośrednio do zasad polityki reklamacji, tabel rozmiarów oraz głównych kategorii asortymentu. W sektorze B2B ułatwiasz menedżerom generowanie zestawień ofertowych, w których Twoja marka zostanie opisana zgodnie z prawdą. Unikasz w ten sposób sytuacji, w której sztuczna inteligencja przedstawia nieaktualne ceny lub przypisuje Ci usługi, których w ogóle nie świadczysz.
Jak prawidłowo stworzyć i wdrożyć plik llms.txt?
Prawidłowe stworzenie i wdrożenie pliku llms.txt polega na przygotowaniu pliku tekstowego z nagłówkiem, krótkim streszczeniem serwisu oraz listą linków do najważniejszych podstron z ich jednoznacznym opisem. Pracę zaczynasz od utworzenia zwykłego dokumentu z rozszerzeniem .txt zapisanego w kodowaniu UTF-8. Na samym początku umieszczasz nazwę projektu poprzedzoną pojedynczym symbolem krzyżyka oraz krótki akapit wyjaśniający, komu pomagasz. Następnie tworzysz sekcje z odnośnikami do najważniejszych działów, pamiętając o dodaniu jednego lub dwóch zdań wyjaśnienia przy każdym adresie. Gotowy plik wgrywasz na serwer do katalogu głównego, aby wyświetlał się bezpośrednio po wpisaniu adresu domeny z ukośnikiem i nazwą pliku.
Serwer powinien zwracać nagłówek tekstowy, który pozwoli zewnętrznym botom natychmiast rozpoznać zawartość bez próby renderowania grafiki. Jeśli dysponujesz ogromną bazą wiedzy, możesz dodatkowo przygotować wersję rozszerzoną o nazwie llms-full.txt zawierającą pełne artykuły w jednym strumieniu znaków. Pamiętaj, aby regularnie klikać we wszystkie zamieszczone odnośniki i eliminować adresy prowadzące do stron z błędem 404. Warto sprawdzić działanie całości, wklejając treść dokumentu do okna asystenta i prosząc go o krótkie podsumowanie profilu Twojej działalności. Taki test natychmiast ujawni, czy zawarte opisy są wystarczająco jednoznaczne dla odbiorcy cyfrowego.
FAQ – najważniejsze informacje o llms.txt
Czym różni się llms.txt od robots.txt i ai.txt?
Plik robots.txt koncentruje się na blokowaniu lub zezwalaniu robotom na dostęp do wskazanych katalogów na serwerze za pomocą prostych poleceń. Plik ai.txt służy głównie do wyrażania zgody lub sprzeciwu wobec wykorzystywania zawartości witryny do trenowania kolejnych generacji oprogramowania. Z kolei omawiany llms.txt nie zawiera żadnych zakazów ani regulacji licencyjnych, lecz pełni funkcję przewodnika po treściach. Każdy z tych plików odpowiada za inny obszar komunikacji między administratorem strony a zewnętrznym oprogramowaniem. Możesz bez przeszkód stosować wszystkie trzy rozwiązania jednocześnie na jednym serwerze.
Jak sprawdzić poprawność pliku llms.txt?
Weryfikację poprawności pliku zaczynasz od wpisania jego pełnego adresu w pasku przeglądarki i sprawdzenia, czy strona otwiera się bez żadnych przekierowań. Następnie upewniasz się, czy serwer zwraca kod powodzenia 200 oraz czy tekst zachowuje czytelne formatowanie nagłówków i akapitów. Warto przekleić zawartość do prostego edytora kodu, aby upewnić się, że polskie znaki diakrytyczne wyświetlają się prawidłowo dzięki kodowaniu UTF-8. Ostatnim krokiem jest wklejenie tekstu do dowolnego programu opartego na modelu językowym z prośbą o wyciągnięcie najważniejszych wniosków. Jeśli asystent bez trudu wymieni Twoje usługi i poprawnie wskaże linki, plik został skonstruowany bezbłędnie.
Czy plik llms.txt jest przydatny i warto go wdrożyć?
Wdrożenie tego rozwiązania okazuje się pożyteczne wszędzie tam, gdzie precyzja odpowiedzi asystentów cyfrowych bezpośrednio wpływa na decyzje podejmowane przez Twoich odbiorców. Choć obecność pliku nie podniesie automatycznie pozycji w wyszukiwarce, ułatwi programom generatywnym dotarcie do faktów na temat Twoich rozwiązań. Koszt przygotowania takiego dokumentu jest znikomy, a proces wdrożenia zajmuje zwykle kilkadziesiąt minut pracy redakcyjnej. Dajesz w ten sposób wyraźny sygnał maszynom, które materiały w Twoim serwisie mają dla Ciebie największe znaczenie edukacyjne. Jest to pragmatyczne działanie porządkujące wiedzę o Twojej ofercie w świecie algorytmów konwersacyjnych.
Jak często aktualizować plik llms.txt?
Aktualizację pliku należy przeprowadzać za każdym razem, gdy wprowadzasz istotne zmiany w ofercie, zmieniasz strukturę adresów URL lub publikujesz nowe materiały edukacyjne. Jeśli Twoja firma uruchamia nową usługę albo wycofuje stary pakiet, dane w pliku tekstowym powinny odzwierciedlać ten fakt tego samego dnia. W przypadku rzadko modyfikowanych stron wystarczy przejrzeć zawartość raz na kwartał, by upewnić się, że żaden z podlinkowanych adresów nie przestał działać. W dużych portalach internetowych warto zautomatyzować ten proces za pomocą skryptów wbudowanych w system zarządzania treścią. Zapewniasz w ten sposób spójność informacji pobieranych przez boty z rzeczywistym stanem Twojego serwisu.
